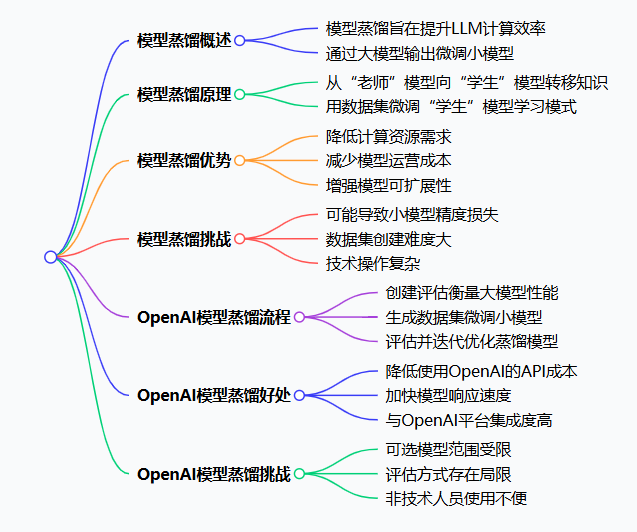
模型蒸馏是一种提高大型语言模型(LLM)计算效率的技术,它采用更大、更复杂的模型的输出,并使用它们来微调较小的模型,以达到类似的性能。如果你一直在努力解决高资源需求或延迟问题,模型蒸馏提供了一个实用的解决方案。
什么是模型蒸馏?
模型蒸馏涉及使用更大、功能更强大的模型的输出来微调更小、更具成本效益的语言模型。目标是使微调模型的性能与给定任务中较大模型的性能相当。如果成功,这将在不牺牲准确性或可靠性的情况下部署更快、更具成本效益的AI应用程序。
模型蒸馏是如何工作的?
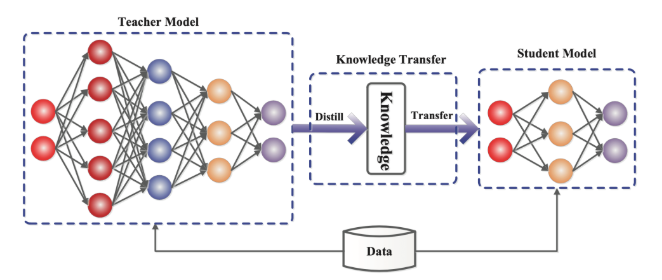
模型蒸馏的工作原理是将知识从一个大型、复杂的语言模型(“老师”)转移到一个更小、更高效的模型(称为“学生”)中。该过程首先生成一个数据集,其中教师模型为各种输入提供输出。此数据集捕获教师的行为和决策模式,作为学生模型的丰富信息来源。
然后,使用此数据集对学生模型进行微调,学习模拟教师对各种输入的反应。通常采用温度缩放等技术来软化教师的输出概率,使学生更容易学习细微的模式。这种方法是大型语言模型知识提炼的核心,使学生能够掌握复杂的概念,而无需大量的训练数据。
模型蒸馏的优势
模型蒸馏为使用大型语言模型(LLM)的企业提供了几个显著的优势。
提高计算效率
主要好处之一是减少了部署所需的计算资源。通过将大型语言模型提炼成更小、更高效的版本,企业可以最大限度地提高LLM性能,同时减少计算开销和延迟。
降低模型成本
成本效益是另一个主要优势。较小的型号消耗的能源更少,需要的硬件功能也更少,从而降低了运营费用。这使得大型语言模型的知识提炼成为一种有吸引力的策略,适用于希望在不产生高昂成本的情况下扩展其AI解决方案的企业。
增强的可扩展性
LLM模型蒸馏增强了可扩展性和可访问性。通过在更广泛的平台(包括移动和边缘设备)上提供高级AI功能,企业可以覆盖更广泛的受众并提供更通用的服务。
模型蒸馏的挑战
尽管有其好处,但模型蒸馏还是带来了组织需要解决的几个挑战。
精度损失
当你将大型语言模型提炼成较小的语言模型时,学生模型可能无法完全捕捉到教师模型的细微差别,从而导致复杂任务的性能下降。
创建正确的数据集
另一个挑战在于数据生成过程。创建用于训练学生模型的综合教师模型输出数据集可能非常耗时且计算密集。确保此数据集充分代表教师的全部能力对于有效的大型语言模型蒸馏至关重要。
技术复杂性
技术复杂性也是一个因素。微调 Student 模型需要选择适当的超参数和优化技术的专业知识。此外,在LLM模型蒸馏过程中,必须特别注意防止教师模型中存在的偏差的传播,这可能会使训练过程复杂化。
模型蒸馏入门
使用 OpenAI 进行模型蒸馏
OpenAI提供了一个结构化的流程来提取模型,利用 Evaluations 和 Stored Completions 等工具。以下是分步指南:
-
创建评估: 首先创建一个评估来衡量你希望从中提炼的较大模型的性能,比如 GPT-4o。此评估将帮助你量化蒸馏模型所需的性能,并作为基准来持续测试蒸馏模型与原始模型的性能,确保它在部署之前满足你的标准。
-
生成带有Stored Completions的蒸馏数据集 :使用较大的模型为与你的应用程序相关的各种输入提示生成输出。对 Chat Completions 端点进行 API 调用时,设置 store:true 标志。这会自动保存输入-输出对,而不会影响延迟。
response = client.chat.completions.create(
model=“gpt-4o”,
messages=[
{
“role”: “user”,
“content”: [
{
“type”: “text”,
“text”: “what’s the capital of the USA?”
}
]
}
],
store=True,
metadata={“username”: “user123”, “user_id”: “123”, “session_id”: “123”}
)
查看、筛选和标记这些存储的补全,以创建适合微调的高质量数据集。此数据集从较大的模型中捕获知识,这对于大型语言模型的知识提炼至关重要。
微调较小的模型 :使用特选数据集作为你的训练文件。将其上传到 OpenAI 的平台以启动微调过程。在开始微调过程以将大型语言模型提炼到你选择的较小模型中之前,调整学习率、批量大小和纪元数等设置以优化训练。这有助于较小的模型(如 GPT-3.5-turbo)有效地从提取的数据中学习。
- 评估蒸馏模型 :使用前面设置的评估来评估蒸馏模型的性能。将其输出与原始较大模型的输出进行比较。根据已建立的LLM基准检查准确性、相关性和连贯性等关键指标,以确定模型是否符合你的性能标准。
- 迭代和优化 :如果蒸馏模型的性能未达到预期,请确定其性能不佳的区域。添加更多示例,尤其是关注有问题的区域:这增强了数据集对较小模型的教学能力。微调超参数以查看性能是否有所提高。通过微调和评估进行迭代,直到提炼模型的性能令人满意。
- 部署蒸馏模型 :模型满足你的条件后,使用 OpenAI 的 API 进行部署。利用较小模型的效率,跨各种平台和设备扩展你的应用程序。
OpenAI 模型蒸馏的好处
- 降低API成本 :模型蒸馏是一种在不牺牲性能的情况下降低API成本的非常有效的方法,前提是蒸馏的模型与更大的模型性能相匹配。
- 更快的响应时间 :较小的模型运行得更快,这使得模型蒸馏成为减少延迟的有效方法。
- 集成平台 :模型蒸馏与OpenAI的平台集成,如果你已经在使用 OpenAI,则更容易上手。
OpenAI 模型蒸馏的挑战
- 型号选择受限: OpenAI 模型蒸馏仅限于它们所服务的模型,例如 GPT-4o。这意味着你无法微调像 Claude Haiku 这样小而强大的模型。
- 有限的评价: OpenAI 要求你在创建评估器之前上传包含提示和完成项的 JSON 文件。评估者和判断类型当前受到限制。
- 专业的用户界面: 用于在OpenAI上收集数据和运行评估的用户界面专为技术用户设计,这使得非技术领域专家难以提供有关模型输出的关键反馈。
- 无法自托管: OpenAI不允许你自托管评估或模型数据来提取可以自托管的开源模型。