基础模型是人工智能 (AI) 领域的一项革命性进步,有望改变我们与计算机和世界的互动方式。这些模型是通过对大量未标记数据进行自我监督学习而创建的,能够以惊人的准确度掌握模式和关系。它们在图像分类、自然语言处理和问答等任务中表现出色。

基础模型构成了生成式人工智能的基础,使它们能够根据给定的提示预测序列中的下一个项目,从而生成文本、音乐和图像。基础模型的未来是光明的,这受到大量数据集的可用性、计算基础设施的进步以及对人工智能应用日益增长的需求等因素的推动。
谷歌的 LLM Jurassic-1 Jumbo 于 2022 年发布,是迄今为止最大的语言模型,拥有惊人的 1.75 万亿个参数。OpenAI 的 DALL-E 2 于 2023 年推出,是一种文本到图像的扩散模型,可以根据文本描述生成逼真的图像,从而实现多样化的视觉内容创作。
什么是基础模型?
基础模型是广泛的机器学习模型,它们在大量数据集上进行训练,使其能够适应各种任务。这些模型通常使用自监督学习或半监督学习方法进行训练,通过利用未标记的数据进行泛化,与特定任务模型相比具有显著优势。它们在自然语言处理、计算机视觉和机器人等领域表现出色。突出的例子包括 GPT-3,它在生成文本、语言翻译和创意内容方面表现出色,以及 BERT,它在问答和情绪分析等任务上表现出色。另一个出色的模型 DALL-E 2 可以根据文本描述生成逼真的图像。
基础模型通常采用由相互连接的神经元层组成的深度神经网络来掌握复杂的数据模式。这些网络的规模可能非常庞大,具有数百万甚至数十亿个参数,因此需要大量计算资源进行训练。然而,它们的庞大规模使它们能够有效地捕捉复杂的模式和关系,从而有助于它们在各种任务中表现出色。
基础模型的历史
多年来,基础模型的发展历史见证了多个重要的里程碑。
- 20 世纪 80 年代 :第一个基于前馈神经网络的模型诞生,使学习简单模式成为可能。
- 20 世纪 90 年代 :循环神经网络 (RNN)得到发展,能够学习文本等序列模式。21 世纪初引入的词向量有助于理解单词之间的语义关系。
- 21 世纪 10 年代 : 人们开始关注机制,通过关注输入数据的相关部分来提高模型性能。
- 2018 年有两大突破: 在庞大的文本数据集上进行预训练的生成式预训练 Transformer 模型 GPT 和在庞大的文本和代码数据集上进行预训练的 BERT 模型。
- 2020 年代 :基础模型继续快速发展,出现了比 GPT 和 BERT 更大、更强大的模型。这些模型在各种自然语言处理任务中取得了最佳效果。
基础模型的开发仍在进行中,有望未来出现更强大、用途更广泛的模型。
基础模型的类型
基础模型有很多种类型,但大致可以分为三类:
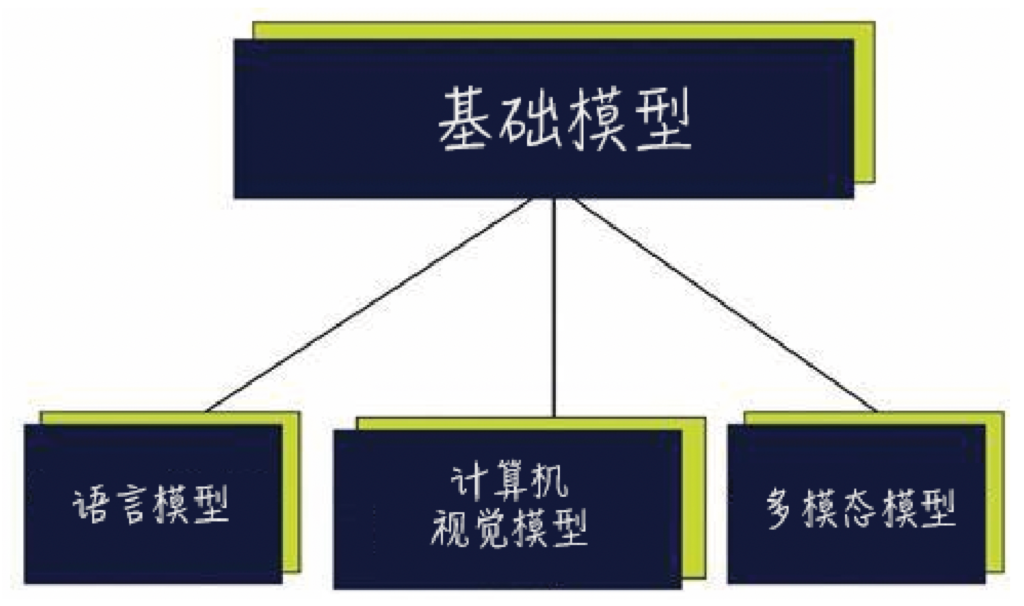
- 语言模型: 这些模型旨在处理和理解自然语言,从而使其能够执行语言翻译、问答和文本生成等任务。流行的语言模型示例包括 BERT、GPT-3 和 T5。
- 计算机视觉模型: 这些模型旨在处理和理解视觉数据,从而使其能够执行图像分类、对象检测和场景理解等任务。流行的计算机视觉模型的示例包括 ResNet、VGG 和 Inception。
- 多模态模型: 这些模型旨在处理和理解自然语言和视觉数据,从而使它们能够执行文本到图像合成、图像字幕和视觉问答等任务。流行的多模态模型包括 DALL-E 2、Flamingo 和 Florence。
自然语言处理是人工智能的一个领域,它帮助计算机理解、解释和操纵人类语言。
基础模型的应用
大型基础模型(例如 DeepMind 的 Alphacode)已经证明了代码生成的有效性,并在编程竞赛中取得了令人印象深刻的成绩。过滤模型输出并实施验证过程可以显著提高准确性。Github Copilot 的编码工具等代码生成工具已经广受欢迎。最近的研究表明,大型语言模型可以通过生成自己的合成谜题来学习编码,从而得到改进。使用 GPT-3 等系统展示了它们卓越的代码生成能力。
语义搜索

语义搜索利用大型语言模型将文本嵌入向量,从而通过余弦相似度轻松检测语义重叠。由于大型向量需要大量计算,因此实现此搜索具有挑战性。Google 和 Facebook 等公司开发了 FAISS 和 ScaNN 等库。开源选项包括 Haystack、Jina.AI 和 Pinecone 和 Weaviate 等供应商选项。
跨模态
Flamingo 等较新的模型通过使用感知器重采样器将图像转换为标记序列来集成视觉和文本。另一篇论文介绍了苏格拉底模型,其中大型视觉、语言和音频模型可以通过语言提示进行协作以完成新任务。
CLIP 和图像生成
OpenAI 推出的 CLIP 模型实现了文本和图像之间的跨模态理解。它使用对比训练来匹配图像-文本对,并为两者创建强大的嵌入。这些嵌入可用于线性探测和零样本学习等任务。CLIP 的改进已经出现,例如 OpenCLIP。图像字幕和生成可以分别通过结合 CLIP 与 GPT-2 或 DALL-E 2 来实现。Parti 和 StableDiffusion 等其他模型提供了替代方法。这些模型的应用正在迅速扩展,包括图像到图像、视频生成和 Photoshop 插件。提示这些模型是一个令人着迷的领域,具有未来工具和基于代码的交互的潜力。随着人工智能模型的不断进步,激动人心的时刻就在眼前。
基础模型的局限性
- 数据集偏差 :基础模型是在大规模数据集上训练的,而数据中可能存在偏差。这些偏差可能会反映在模型的输出中,从而可能导致不公平或有偏差的结果。
- 缺乏领域特异性 :基础模型在多样化的数据源上进行训练,这可能会限制它们在特定领域或行业中的表现。
- 可解释性挑战 :理解和解释这些模型的内部工作原理可能很困难,这使得信任其决策过程和识别潜在的错误或偏见变得具有挑战性。
- 高计算要求 :训练和使用基础模型通常需要大量的计算资源,包括强大的硬件和大量的内存。
- 缺乏语境理解 :虽然基础模型具有令人印象深刻的语言生成能力,但它们可能仍然难以对语境、幽默、讽刺或文化参考进行细致的理解。
基础模型的未来方向
持续进步
预计基础模型将在模型规模、训练方法、应用领域、可解释性和安全性等方面不断进步,从而产生更强大、更高效、适用范围更广、应用创新的人工智能系统。
多模态能力
未来的基础模型有望融入多模态学习,使其不仅能够处理和理解文本,还能处理和理解图像、音频和视频。这将为图像字幕、视频摘要和语音识别等应用开辟新的机会。
合作与社区发展
研究人员、开发人员和开源社区之间的合作将在推动基础模型的未来发展和改进方面发挥关键作用。社区努力将促进创新、知识共享和人工智能技术的民主化。
结论
随着基础模型不断发展并改变人工智能的格局,基础模型的未来前景一片光明。在未来几年,我们可以期待开发出更强大、更通用的模型,能够以前所未有的精度处理各个领域的复杂任务。计算基础设施的进步、大量多样化数据集的可用性以及正在进行的研究工作将推动这些模型的发展。
此外,确保这些大型模型及其处理的数据的隐私和安全仍然至关重要。在模型大小和环境影响之间取得平衡是另一个挑战,因为模型越大,能耗就越高。解决这些挑战对于在未来几年充分发挥基础模型的潜力至关重要。